首创全网扁平化组网
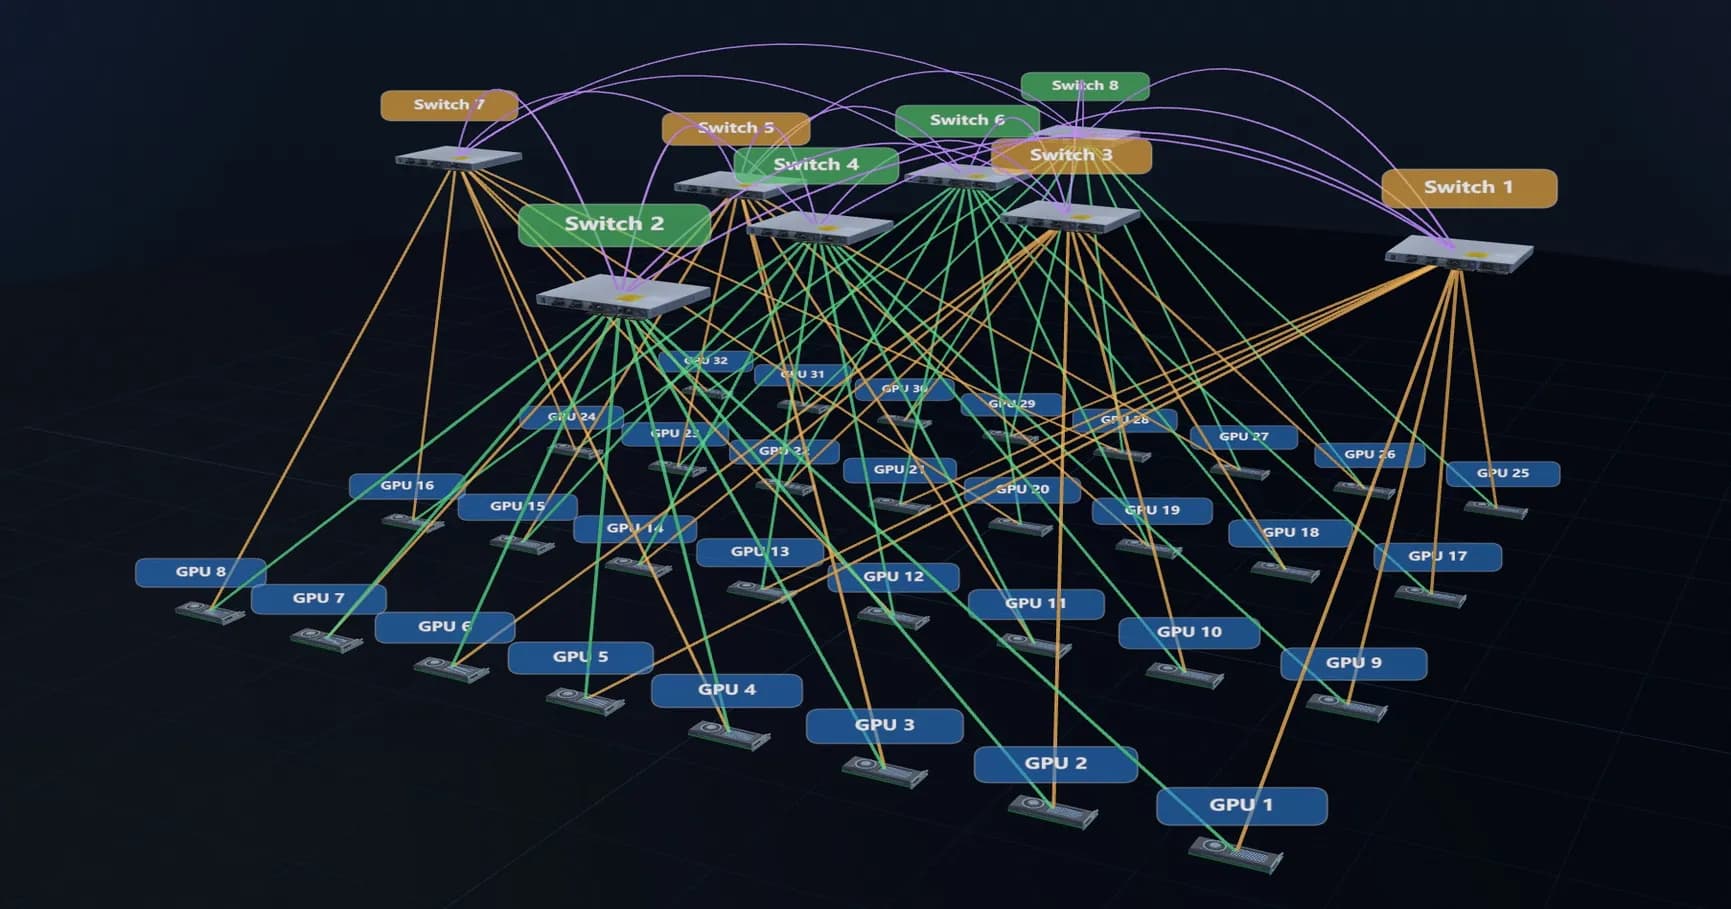
彻底打破传统数据中心多层堆叠的树状架构,取消 Spine 层交换机,将全网互联结构彻底扁平化。
摒弃传统多层树状结构,采用完全扁平的互联架构,取消 Spine 层交换机,配合“单轨+多轨”混合接入与专属路由,为集群内 GPU 通信规划更短、负载更均衡的路径。
产品定位
ZCube 从底层重构 AI 集群计算网,以更少的网络硬件成本、更短的转发路径和更均衡的流量组织方式,充分释放集群算效。
核心能力
核心能力架构
通过物理拓扑与路由策略协同设计,为智算业务构建更短、更均衡的通信路径。
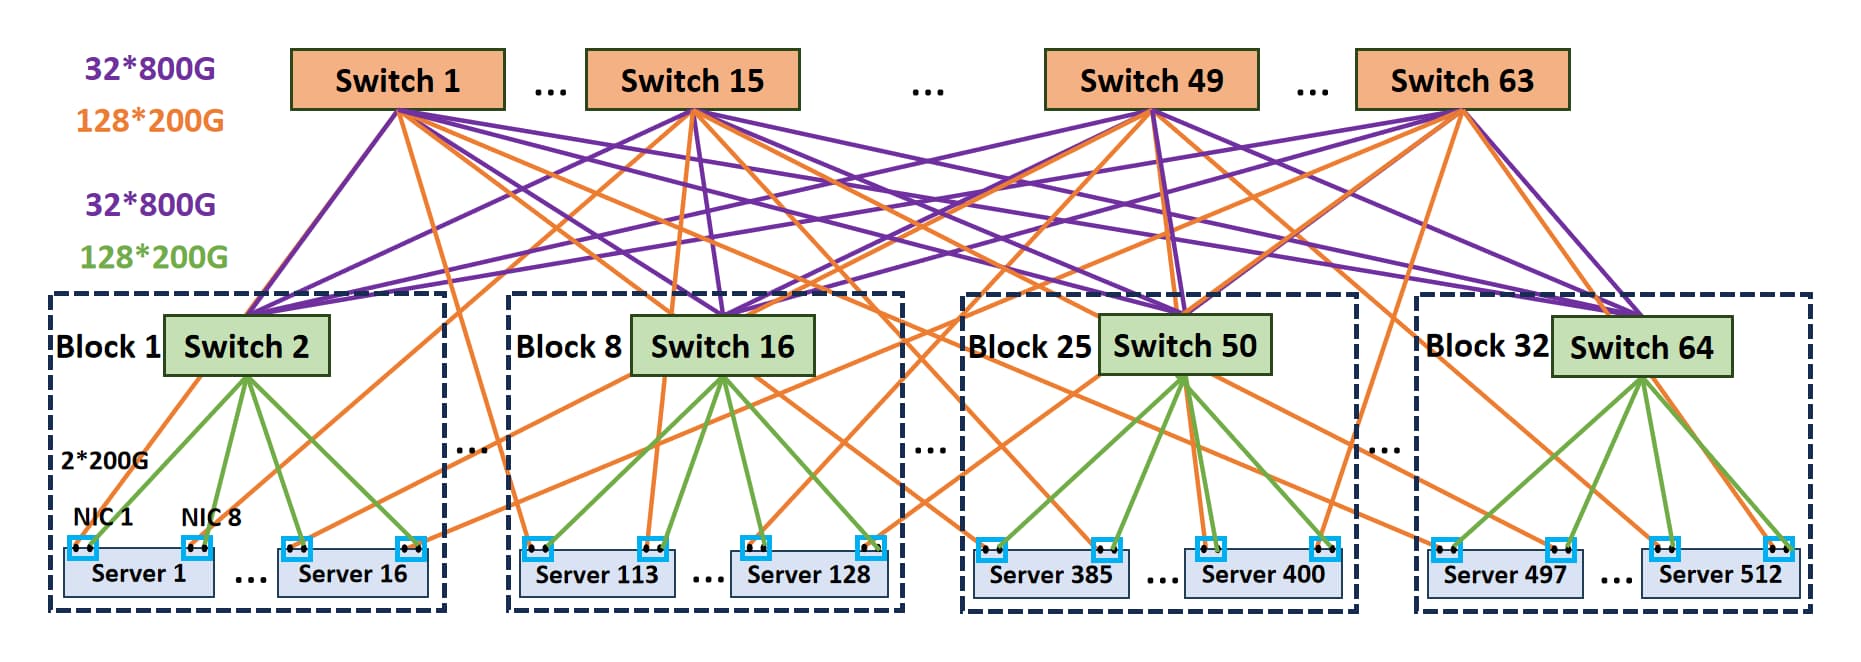
彻底打破传统数据中心多层堆叠的树状架构,取消 Spine 层交换机,将全网互联结构彻底扁平化。
通过独特的网卡接入设计,为集群内任意两块 GPU 之间规划“有且仅有一条”的最优通信路径,从结构上提升网络负载均衡能力。
针对创新的底层拓扑,自研包括 ZCube 路由在内的一整套网络控制软件,实现底层硬件拓扑与上层软件路由协同。
核心软硬件
由 ZCube 交换机、智能体原生操作系统 YZOS、ZCube 控制器和配套部署工具共同构成的 ZCube 生态体系。
交换机和光模块数量减少 1/3,GPU 间 2 跳交换机可达;支持多用户流量物理隔离,并优化 PFC 广播域。
内置 AI Agent,支持拥塞感知的自适应路由和主动路径切换,并支持基于源、目的 IP 选路等 LB 策略。
实时监测设备状态、流量、微突发和端口故障;交换机与控制器协同,实现毫秒级故障自愈。
支持“意图即代码”、领域 Skills 自动构建、真实物理环境验证和基于生产反馈的持续迭代。
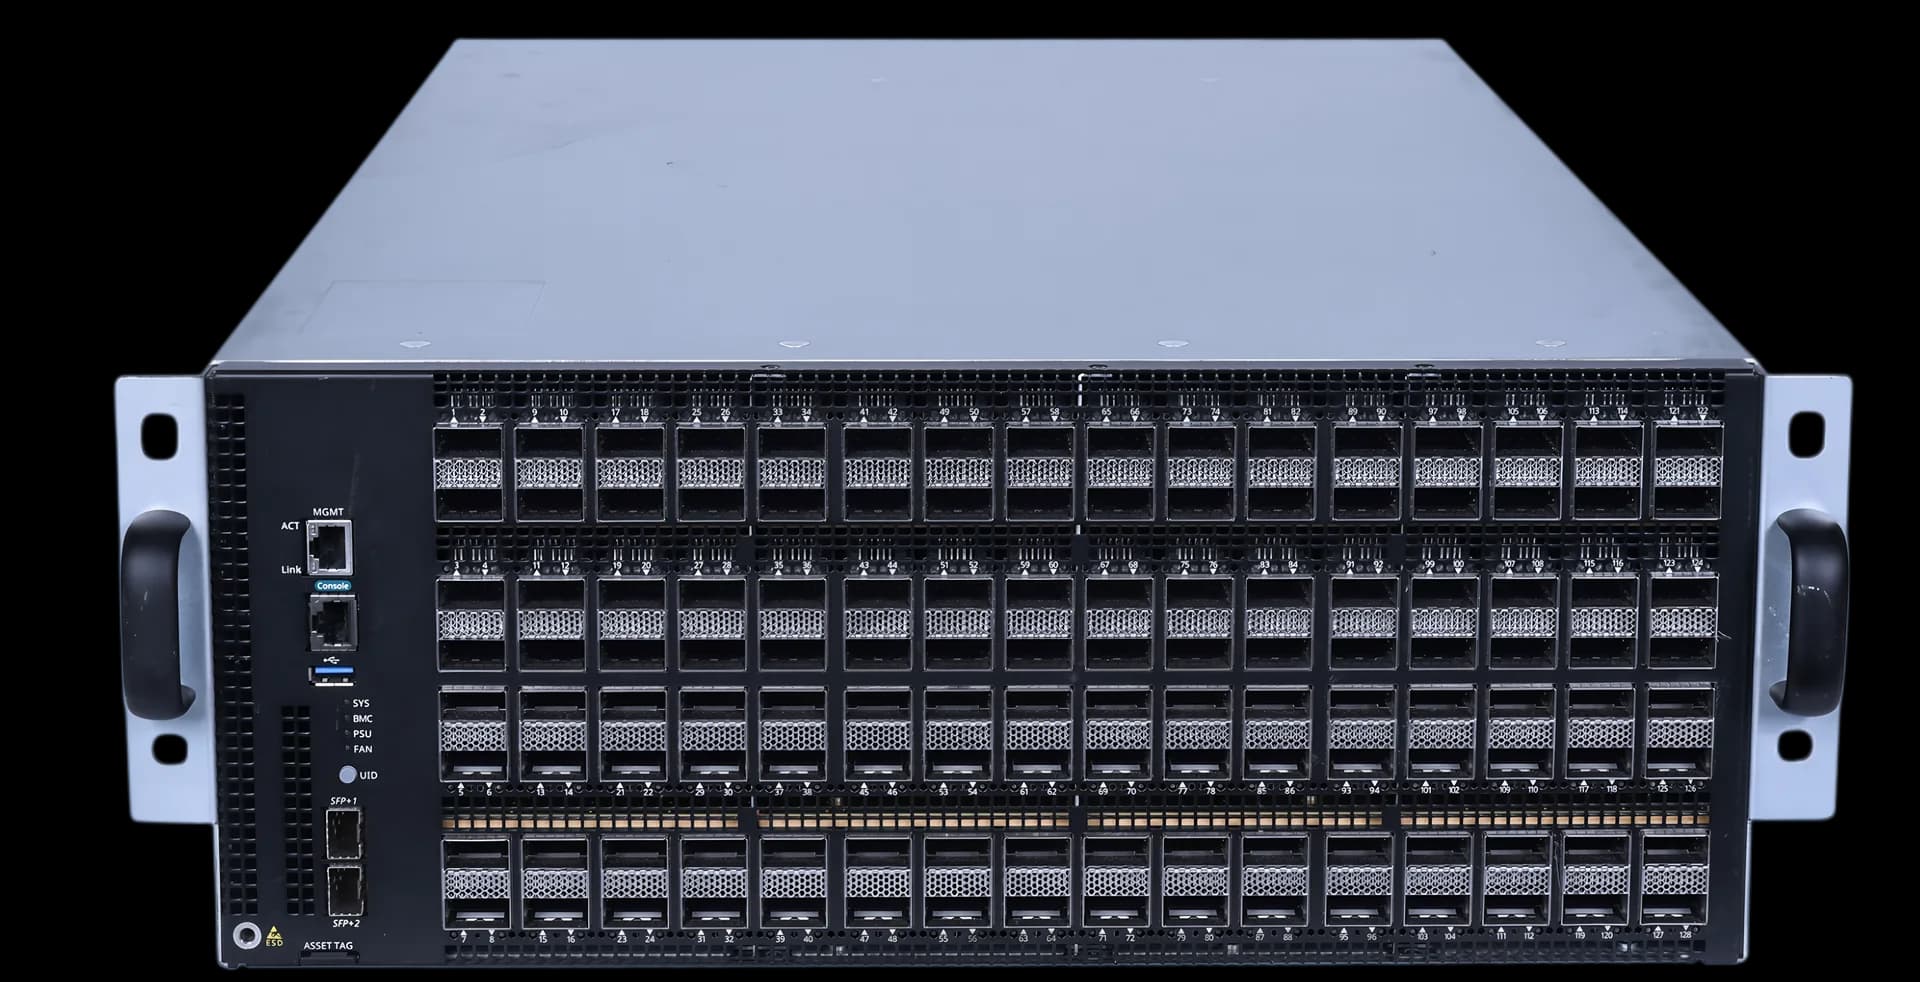
面向高密度智算组网的核心设备,参数以公司产品介绍资料为准。
ZCube 控制器覆盖架构设计、布线纠错、配置下发、故障监控与诊断;支持业务故障自动恢复、RoCE 智能调优、集群扩容与无感替换,以及租户级 GPU 编排,形成自动化运维、业务韧性优化和业务长效运营能力。
价值与效果
以采用 51.2T 交换机(128×400G 端口)构建 16K H200(网卡为 2×200G)集群为例,ZCube 从设备投入、通信路径、负载均衡、故障域和建设周期同步改善组网效率。
交换机数量由 384 台减少至 256 台,网络设备与故障源同步减少。
400G 模块数量由 49152 个减少至 32768 个。
光纤线缆数量由 32768 根减少至 24576 根。
全网 GPU 间只需经过 2 台交换机,通信路径更短。
通过架构与路径协同减少 Hash 冲突和负载不均。
无 Spine 交换机故障,交换机互联链路故障仅波及部分 GPU。
多用户流量由逻辑隔离提升为物理链路隔离。
相比传统方案常规 7~12 天完成建设,业务可更早上线。
应用验证
智算集群部署案例,呈现 ZCube 架构真实落地效果。
基于 Coding 推理服务,对比传统 ROFT 网络架构,验证 ZCube 通过扁平化组网和更均衡网络通信释放推理有效算力。
15%
GPU 平均推理吞吐提升
40.6%
首 Token 时延(TTFT)P99 降低
33%
网络硬件成本减少
在国产智算生态中,对比 ZCube 与传统 Clos 架构在集合通信、训练和推理维度的表现。
14.5%
All-to-All 吞吐提升
22%–30%
TTFT P99 降低
7%–10%
推理吞吐提升
对比 ZCube 与 Clos 架构,在集合通信、模型训练和多租户端到端推理场景中验证性能收益。
119%
集合通信性能提升
20.1%
模型训练吞吐提升
11.5%
推理时延降低
国产算力千卡级集群已上线稳定运行数月,持续承载真实业务流量,并面向真实用户提供服务。
千卡规模
国产算力集群部署
数月
生产环境稳定运行
真实用户
持续提供服务
围绕新建集群、存量改造、性能调优或智能运维,与我们一起评估网络如何释放更多有效算力。